
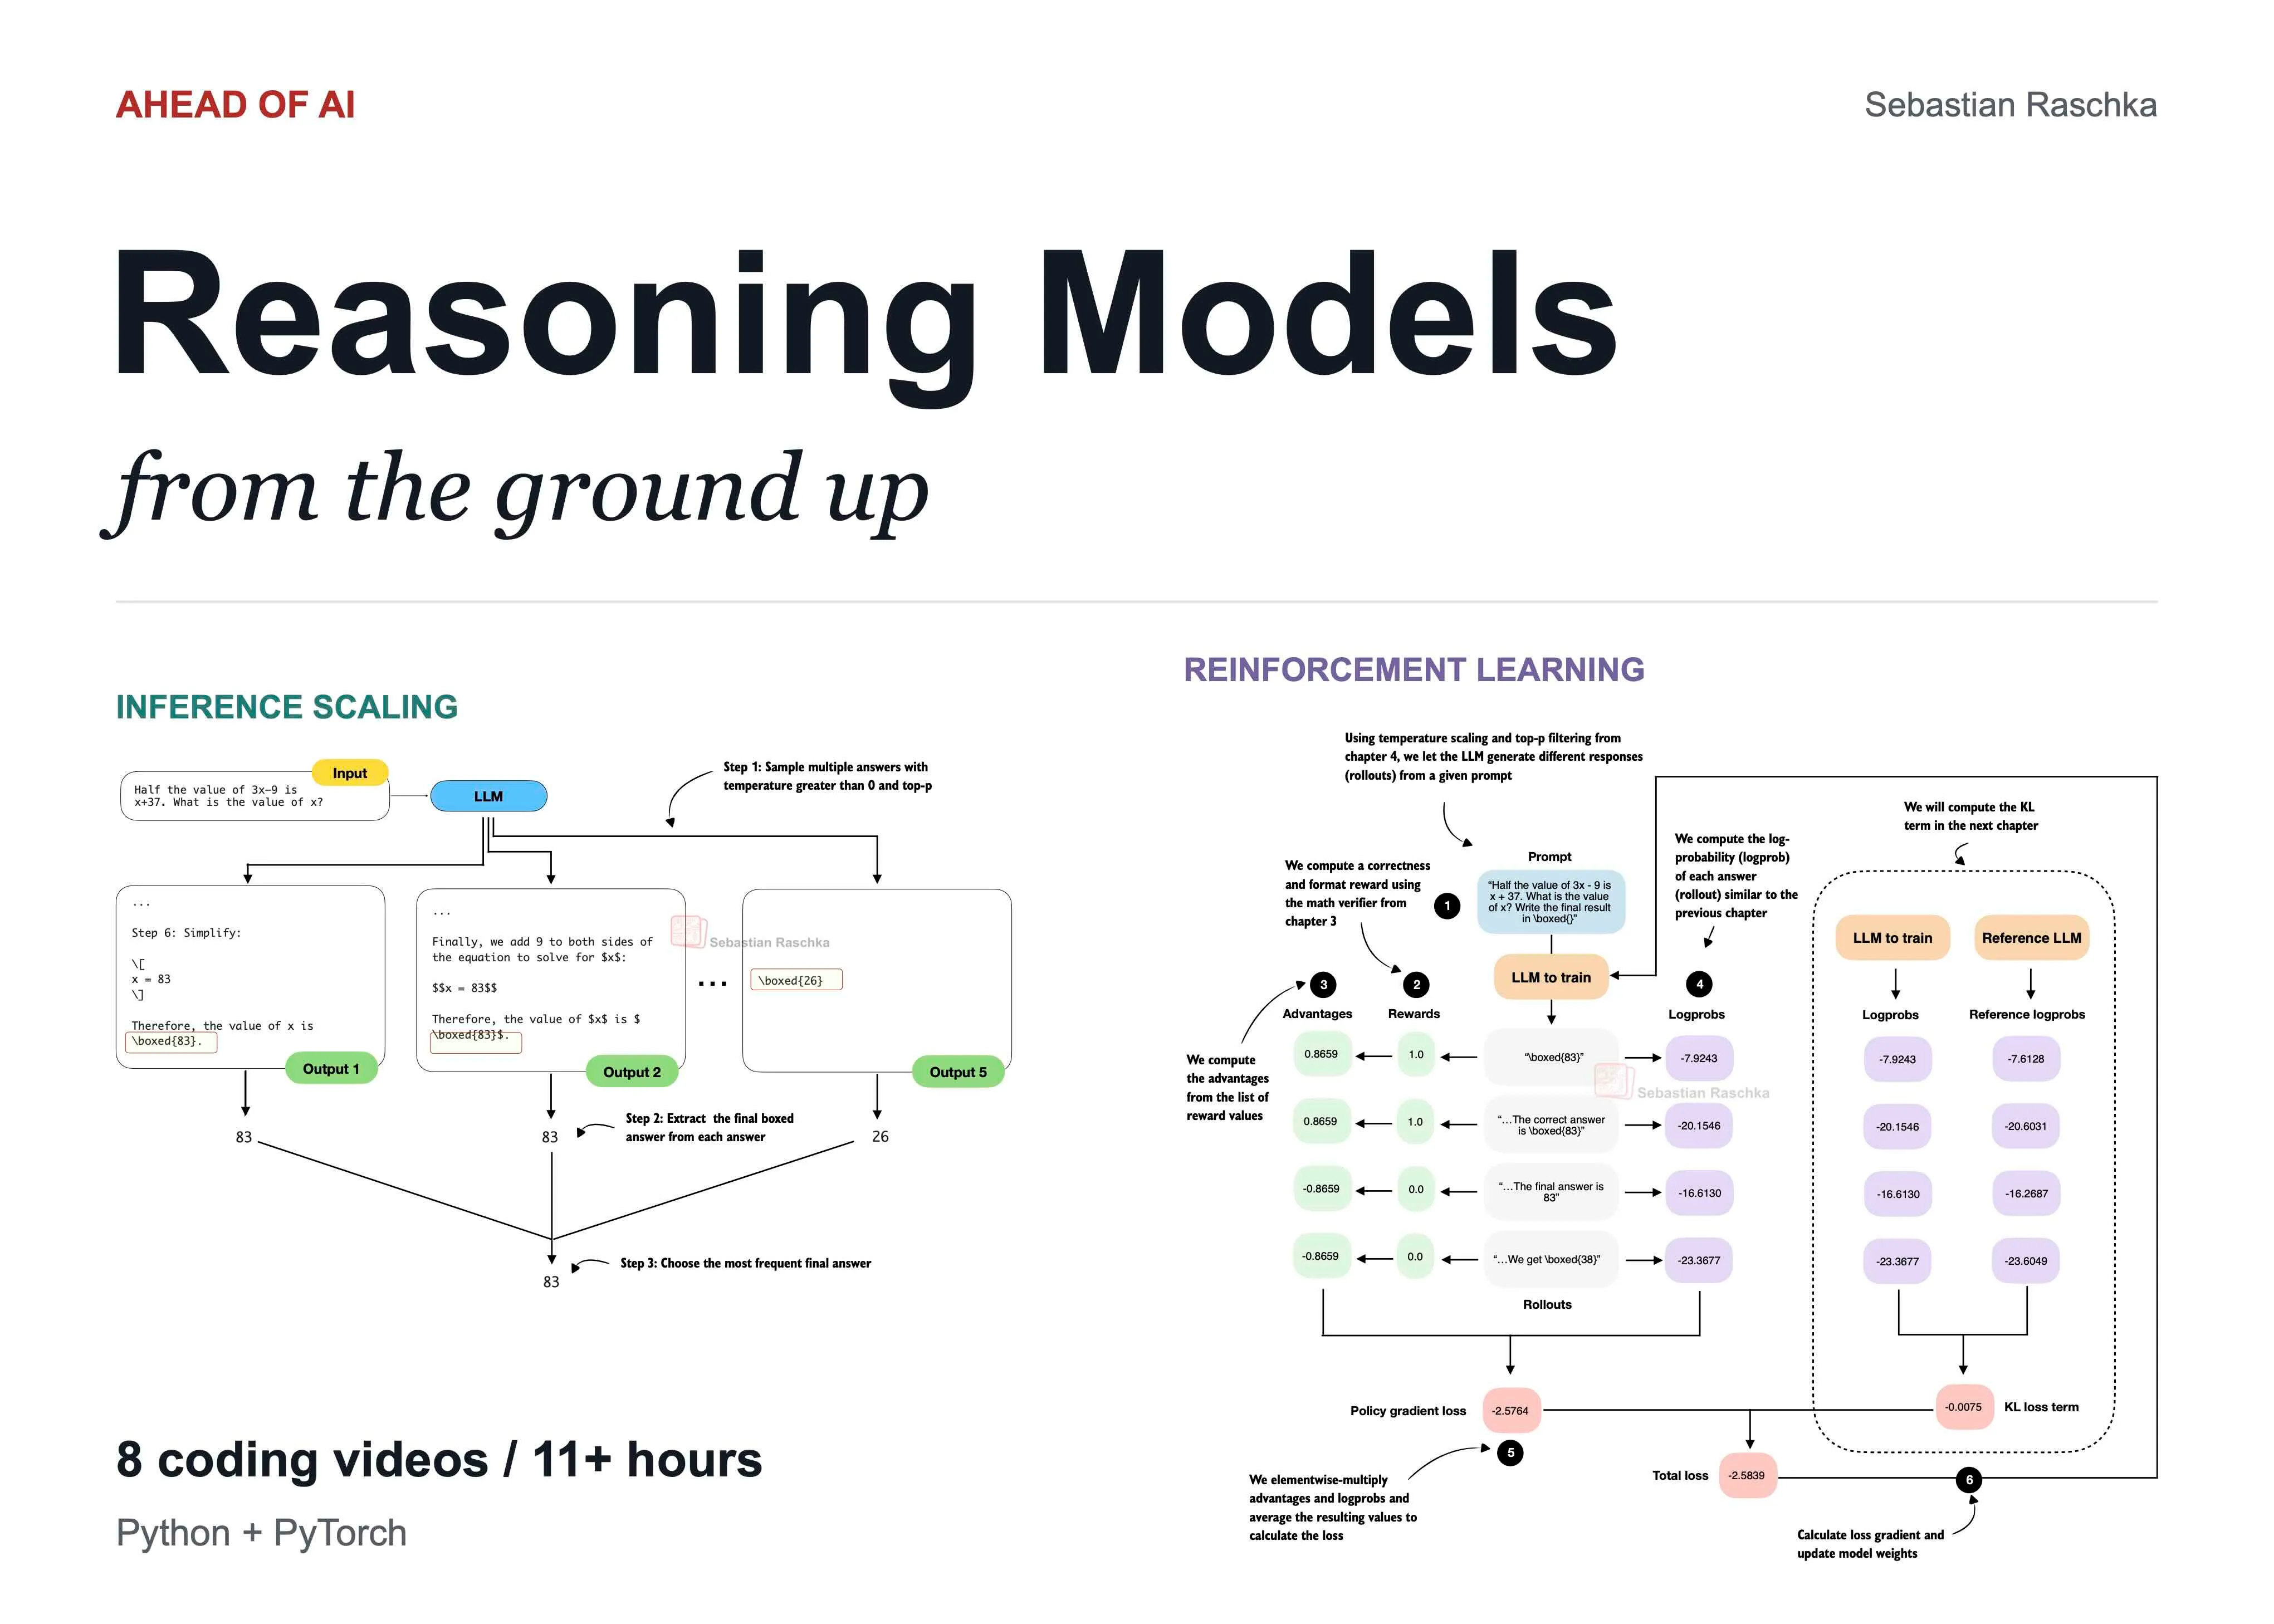
Появление открытых моделей с длинными цепочками рассуждений (chain-of-thought) подтолкнуло бизнес переносить критичные AI-пайплайны в закрытый контур. Мотивация понятна: соблюдение коммерческой тайны, независимость от доступности американских API и фиксация стоимости инференса. Однако развертывание reasoning-модели на собственном оборудовании требует учета специфики ее архитектуры, которая сильно отличается от классических инструктивных LLM.
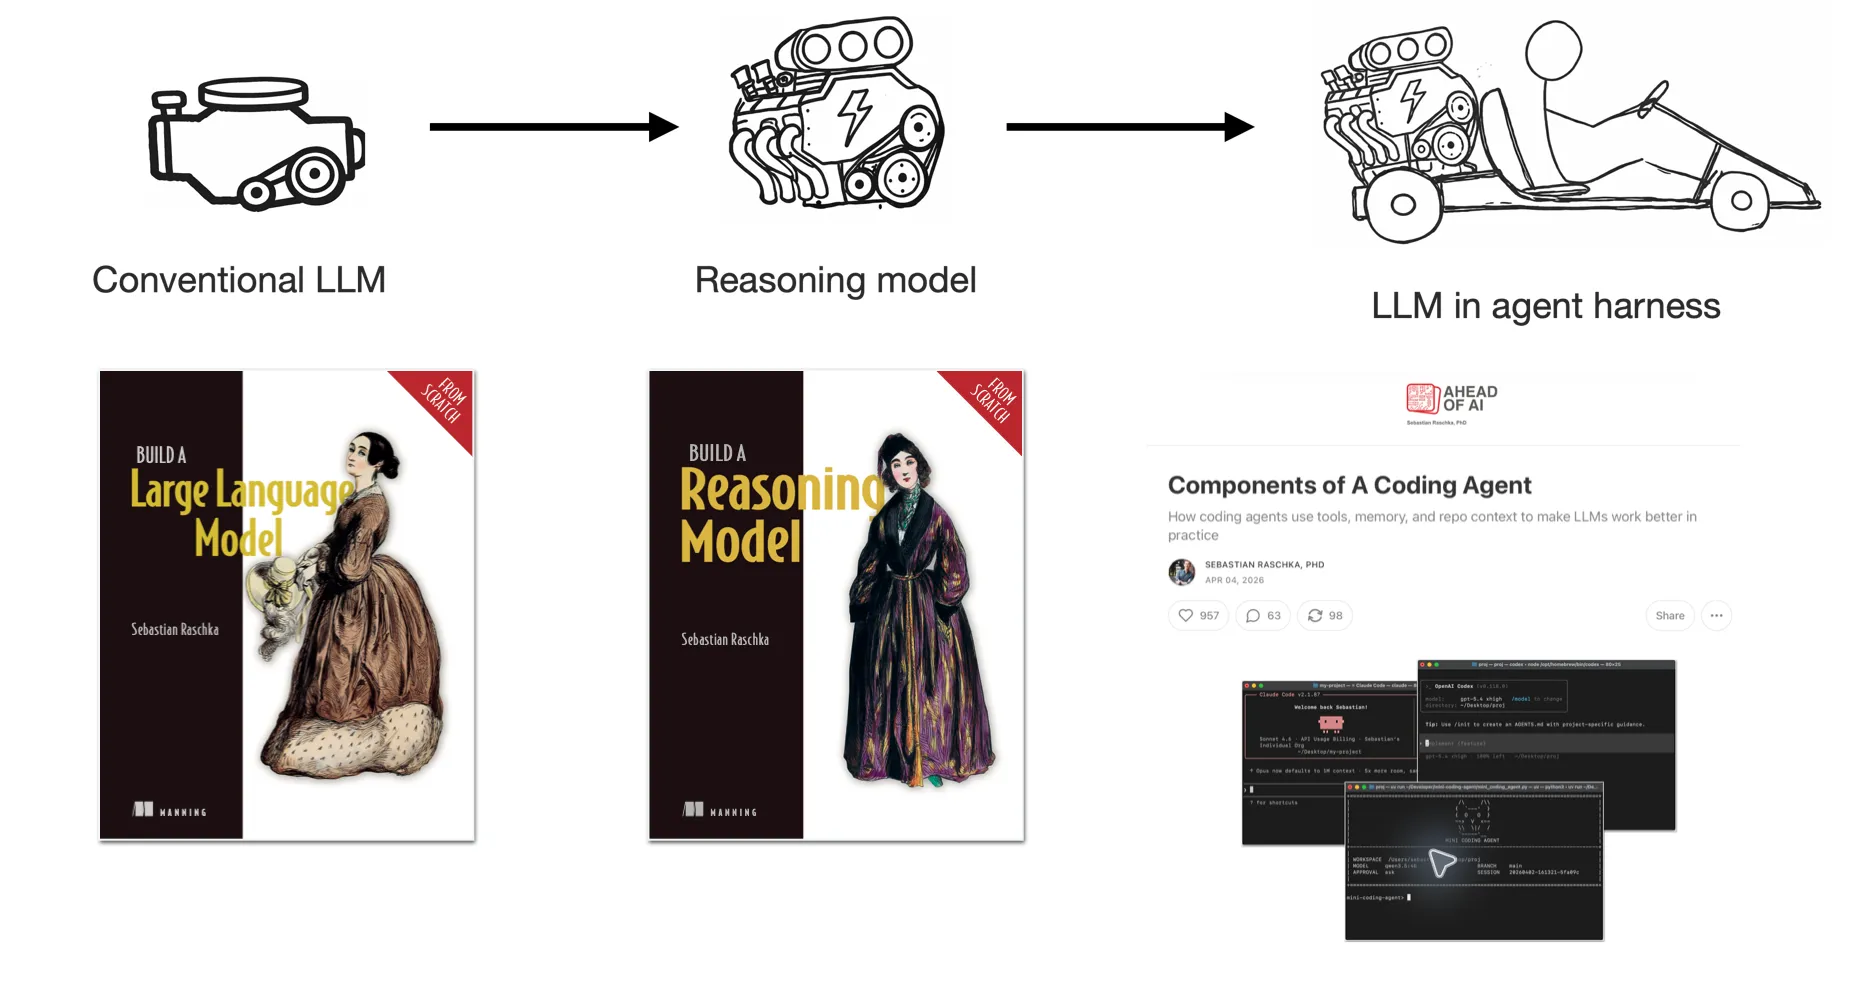
Главное отличие reasoning-моделей — объем генерируемых служебных токенов. Если классическая модель на запрос о проверке договора генерирует 200–400 токенов ответа, модель с цепочкой рассуждений может потратить 3000–8000 токенов на внутреннее сопоставление пунктов, поиск противоречий и самопроверку, прежде чем выдать итоговый вердикт.
Проблема KV-кэша и требования к видеопамяти
При расчете оборудования часто учитывают только вес самой модели. Например, открытая модель на 32 миллиарда параметров в формате FP16 занимает около 64 ГБ VRAM, что позволяет запустить ее на сервере с двумя картами уровня NVIDIA L40S или одной A100 80GB.
Ошибка кроется в оценке KV-кэша при параллельной нагрузке. Поскольку цепочка рассуждений раздувает длину контекста в каждом запросе в 5–10 раз, на хранение промежуточных состояний внимания требуется сопоставимый с весами модели объем памяти:
- При длине контекста в 16 000 токенов один активный поток требует от 2 до 4 ГБ VRAM только под KV-кэш (в зависимости от количества слоев и голов внимания).
- Для обслуживания очереди из 10–15 одновременных запросов потребуется еще 40–60 ГБ быстрой памяти.
- Если памяти не хватает, движок инференса (vLLM или SGLang) вынужден сбрасывать кэш в системную RAM или задерживать обработку (prefill eviction), что увеличивает время ожидания ответа с 3–5 секунд до минут.
Без использования техник постраничного внимания (PagedAttention) и квантования KV-кэша (FP8/INT8) сервер просто захлебывается при первых пиках трафика.
Где 4-битное квантование ломает рассуждения
Популярный способ уложить большую модель в бюджетные серверы — квантование весов до 4 бит (AWQ, GPTQ или GGUF). Для задач генерации текста, суммаризации и диалогов потеря точности при 4-битном сжатии редко превышает 1–2% и практически незаметна пользователю.
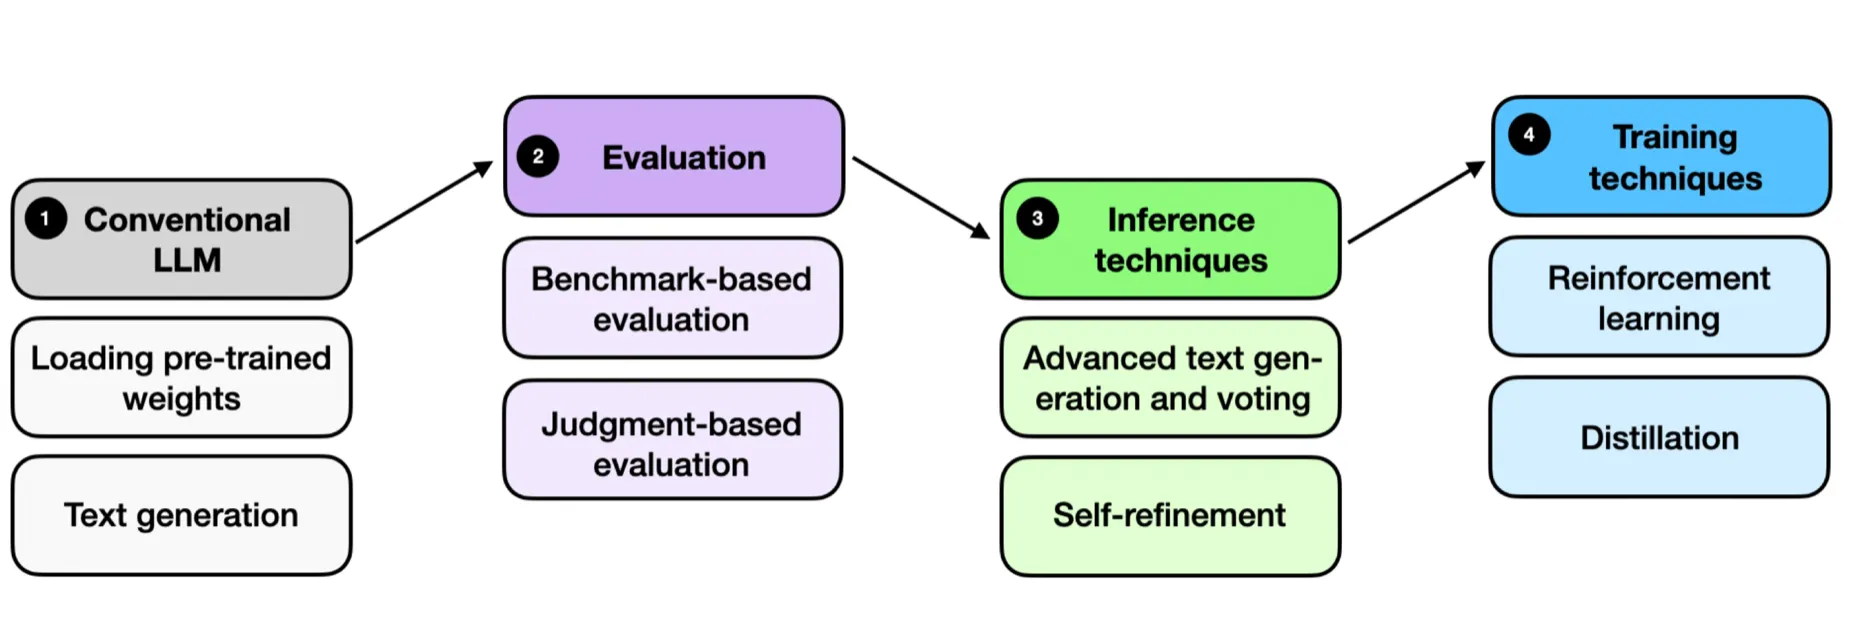
В reasoning-моделях ситуация иная. Длинная цепочка логического вывода представляет собой направленный граф вероятностей. Ошибка округления весов на ранних шагах рассуждения накапливается экспоненциально:
- Строгие форматы: в 4-битных версиях резко возрастает частота синтаксических сбоев при генерации JSON и вложенных структур данных.
- Арифметика и сверка дат: если в 16-битном представлении модель надежно вычисляет штрафы и календарные сроки по сложным условиям, в квантованном виде вероятность арифметической ошибки в середине цепочки рассуждений увеличивается на 12–18%.
- Зацикливание: при агрессивном сжатии модель чаще попадает в бесконечный цикл псевдорассуждений, повторяя одни и те же проверки до исчерпания лимита токенов.
Для производственных контуров с жесткими требованиями к точности нижний порог надежного сжатия весов сегодня проходит по уровню 8 бит (FP8/INT8). Это сохраняет математическую строгость выводов, но требует вдвое больше VRAM, чем любительские 4-битные сборки.
Экономическая граница: облако против своего «железа»
Переход на локальный инференс reasoning-модели оправдан не всегда. Рассмотрим типовой расчет затрат:
- Серверная конфигурация: аренда выделенной ноды с двумя GPU A100 (80GB) в корпоративном облаке обходится примерно в 200 000 – 350 000 руб. в месяц (включая сетевой трафик и резервирование).
- Облачный API: при стоимости вывода современных моделей класса reasoning порядка $2–$5 за миллион токенов (с учетом внутреннего chain-of-thought), бюджет в 300 000 руб. эквивалентен обработке 600–1200 миллионов токенов.
Если компания обрабатывает менее 15 000 сложных документов или запросов в месяц, аренда собственного GPU-кластера экономически убыточна. Локальный контур на этом масштабе оправдан только регуляторными запретами на передачу персональных данных во внешние контуры.
Экономическая целесообразность собственной инфраструктуры начинается от стабильной нагрузки в 40 000 – 50 000 запросов в месяц, либо при необходимости гарантировать предсказуемое время ответа (SLA) без очередей публичных провайдеров.
С чего начинать тестирование
Инженерным командам, планирующим развертывание открытых reasoning-моделей, мы рекомендуем следующий порядок:
- Измерить среднее число служебных токенов на вашей задаче: проверьте, сколько именно токенов рассуждений тратит модель на один полезный ответ.
- Протестировать качество в FP8 перед покупкой серверов под FP16: современные архитектуры GPU (Ada Lovelace, Hopper) аппаратно поддерживают FP8 без потери точности логического вывода.
- Ограничить максимальную длину цепочки рассуждений в системном промпте или конфигурации инференса, чтобы исключить зависание воркеров на некорректных входных данных.